Du sitzt gerade wahrscheinlich in genau so einer Lage: Das Team hängt in der finalen Korrekturrunde, der Kunde wartet auf die letzte Freigabe, und plötzlich sind Server, Dateien oder Zugänge weg. In Agenturen passiert das nicht nur bei spektakulären Großausfällen, sondern oft mitten im Alltag, wenn ein Cloud-Dienst hakt, ein Konto kompromittiert wird oder ein Speicherort schlicht nicht mehr erreichbar ist. Ein Disaster Recovery Plan ist dann kein IT-Dokument fürs Archiv, sondern die Entscheidung, ob dein Projekt weiterläuft oder im Chaos versinkt.
Inhaltsverzeichnis
- Einführung und Bedeutung eines disaster recovery plan
- Grundlagen verstehen Risikoanalyse und Business Impact Analysis
- Recovery Ziele festlegen RTO und RPO definieren
- Backup Strategien und kreative Assets sichern
- Kommunikations und Verantwortungsplan umsetzen
- Testen pflegen und Auditen deines DR Plans
- Vorlagen Checklisten und bewährte Prozesse
Einführung und Bedeutung eines disaster recovery plan
Ein aktuelles Beispiel aus dem Agenturalltag ist schnell erzählt. Das Kreativteam hat gerade die letzte Version eines Kampagnenfilms für die Endabnahme vorbereitet, der Schnitt ist fast durch, die Kommentare der Kundenseite liegen in mehreren Mails und Chats verstreut vor, dann fällt das zentrale System aus. In so einem Moment zeigt sich brutal klar, wie teuer fehlende Wiederanlaufplanung wird, weil nicht nur Dateien fehlen, sondern auch Freigaben, Versionen und Zuständigkeiten.
Genau deshalb reicht ein Backup allein nicht. Das Bundesamt für Sicherheit in der Informationstechnik (BSI) beschreibt Cyberangriffe als anhaltendes Risiko für Unternehmen und betont, dass DR-Pläne neben Naturkatastrophen ausdrücklich IT-Ausfälle, Ransomware und Systemkompromittierungen abdecken müssen, was den Blick weg von der reinen Technik und hin zu echter Betriebsfähigkeit lenkt. Wer sich zusätzlich mit Datenschutzfragen beschäftigt, findet in Infos von Energieaudit365 zur Blackout-Vorsorge einen nützlichen Blick auf Ausfallvorsorge, während die Schnittstelle zu Datenschutz und Cloud gerade für personenbezogene Daten kritisch bleibt.
"Praktische Regel: Ein Disaster-Recovery-Plan muss so geschrieben sein, dass du ihn unter Stress lesen kannst, nicht nur im ruhigen Büroalltag.
Für KMU, Agenturen und Content-Teams ist das besonders wichtig, weil Arbeitsfähigkeit heute an wenigen Plattformen hängt. Fällt ein System aus, stehen nicht nur interne Prozesse still, sondern oft auch Abnahmen, Releases und Kundendialoge. Ein guter Plan entlastet das Projektmanagement, weil er vorher festlegt, was zuerst wieder online muss, wer spricht und wie Nachweise dokumentiert werden.
Grundlagen verstehen Risikoanalyse und Business Impact Analysis
Eine Agentur ist im Grunde schon mitten im Incident, wenn der Review-Ordner weg ist und niemand mehr sagen kann, welche Datei die finale Version ist. Genau darum musst du vor jedem Schutz wissen, welche Systeme, Assets und Freigabeschritte dein Team wirklich am Laufen halten. Eine Risikoanalyse und eine Business Impact Analysis, kurz BIA, machen sichtbar, welche Anwendungen, Medien und Abhängigkeiten kritisch sind. TechTarget beschreibt den Planaufbau genau in dieser Reihenfolge, erst BIA, dann Risikoanalyse, dann Ziele, Rollen, Bestände, Kommunikation und Wiederherstellungskonzepte, was in der Praxis sauberer funktioniert als ein pauschales „Alles ist wichtig“ (TechTarget zur Disaster-Recovery-Planung).
So gehst du bei der Inventarisierung vor
Starte mit einer Liste, nicht mit einem Tool. Erfasse Hardware, Software, Daten und externe Dienste getrennt, damit du später nicht raten musst, wenn ein Teil der Kette ausfällt. Genau diese Inventarisierung gehört auch zu den Grundelementen, die Ready.gov für Notfall- und Wiederanlaufpläne nennt, zusammen mit Backups, Priorisierung und Tests, und die Anforderungen sind unter Recovering from a Business Disruption praxisnah beschrieben.
Frag dich für jedes Asset ganz konkret:
- Was produziert dieses System eigentlich? Entwürfe, Enddateien, Kommentare, Freigaben oder nur Arbeitskopien.
- Wer nutzt es wirklich täglich? Redaktion, Design, Projektleitung, Kundenseite oder freie Mitarbeitende.
- Welche Abhängigkeiten hängen dran? Speicher, Identitäten, Rendering, Uploads, Review-Links, Archivzugänge.
- Was passiert bei Ausfall zuerst? Verzögerung, Datenverlust, Freigabestopp oder kompletter Projektstillstand.
"Wenn du ein Asset nicht benennen kannst, kannst du es im Notfall auch nicht priorisieren.
Wie du aus der Analyse Entscheidungen machst
Die BIA bewertet nicht nur technische Systeme, sondern den Geschäftsschaden bei Ausfall. Ein Schnittsystem ist zum Beispiel nicht automatisch kritischer als ein Freigabe-Workflow, wenn ohne Freigabe keine Auslieferung stattfinden darf. Viele Teams setzen hier falsch an, weil sie Server für wichtiger halten als operative Engpässe.
Hilfreich ist ein Abgleich mit echten Betriebsfragen, nicht mit Bauchgefühl. Wo entstehen Deadlines, wo liegt Reputationsrisiko, wo hängt die Rechtsseite dran, und welche Daten würden sich nicht einfach nachbauen lassen? Wer dafür einen klaren Dokumentationsrahmen braucht, sollte sich auch die Anforderungen an revisionssichere Dokumentation anschauen, weil eine BIA ohne belastbare Nachweise im Ernstfall schnell wieder im Papierkorb landet.
Ein guter Praxischeck ist oft einfacher als ein großes Framework. Wenn du einen Dienst, ein Laufwerk oder einen Cloud-Ordner abschaltest, solltest du sofort sagen können, welche Projekte stehen bleiben, welche nur verzögert sind und welche Prozesse noch laufen. Genau diese Klarheit spart später Stunden, manchmal Tage.
Für einen Kostencheck von Energiekonzepte4you GmbH zur Heizung-notdienst-Versorgung siehst du hier, Kostencheck von Energiekonzepte4you GmbH.
Was du lieber nicht tust
- Keine pauschalen Kritikalitätsstufen: Alles rot zu markieren hilft niemandem.
- Keine Scheinvollständigkeit: Ein halber Bestand ist gefährlicher als ein kleiner, aber sauberer.
- Keine Abteilungsgrenzen als Datengrenzen: Kreative Assets laufen meist über mehrere Teams.
Wenn du bei der Inventarisierung sauber arbeitest, wird der Rest deutlich einfacher. Dann kannst du Recovery-Ziele realistisch setzen, Backups sinnvoll planen und im Krisenfall ohne Diskussionen entscheiden, was zuerst wiederhergestellt wird. Für Agenturen mit vielen Freigabeschleifen ist das der Unterschied zwischen organisiertem Wiederanlauf und hektischem Datei-Suchen.
Recovery Ziele festlegen RTO und RPO definieren
RTO und RPO klingen technisch, sind aber in Wahrheit Führungsentscheidungen. Das Recovery Time Objective beschreibt, wie lange ein System ausfallen darf, bevor dein Team handlungsunfähig wird. Das Recovery Point Objective legt fest, wie viel Datenverlust noch akzeptabel ist, also wie weit du im Ernstfall zurückspringen darfst.
ISO/IEC 27031 empfiehlt, diese Ziele ausdrücklich zu definieren und regelmäßig zu testen, mit vierteljährlichen Tabletop-Übungen, halbjährlichen Teil-Failover-Tests und jährlichen Vollsimulationen (Atlassian zu Disaster Recovery). In der Praxis heißt das, du setzt Zielwerte nicht nach Gefühl, sondern nach Wirkung auf den Betrieb, die Kundenerwartung und die tatsächliche Wiederherstellbarkeit.
RTO und RPO am Projektalltag messen
Ein Freigabeportal kann ein anderes RTO haben als das Archiv. Wenn das Archiv ein paar Stunden später verfügbar ist, bricht das selten sofort alles zusammen. Wenn aber Review-Links, Kommentarhistorien oder finale Master-Dateien fehlen, verschiebt sich die gesamte Abnahme. Deshalb musst du pro Prozess statt pro Tool denken.
"Merke: Das kritischste System ist oft nicht das lauteste, sondern das, ohne das keine Entscheidung mehr getroffen werden kann.
Ein einfacher Weg ist, jedes Kernsystem drei Fragen zu stellen:
- Wie schnell muss es wieder da sein?
- Wie viel Arbeit kann in der Zwischenzeit neu erzeugt werden?
- Welche Daten wären nach einem Verlust nicht mehr exakt rekonstruierbar?
Bei Kreativteams ist die Antwort oft asymmetrisch. Die Rohdaten lassen sich mit Aufwand erneut sichern, aber Annotationen, Freigaben und Versionsentscheidungen lassen sich nicht sauber nachbauen. Deshalb sollte das RPO bei kollaborativen Assets in der Regel enger betrachtet werden als bei rein archivierten Inhalten.
Wie du Zielwerte dokumentierst
Halte RTO und RPO nicht als abstrakte Tabelle fest, sondern direkt neben dem jeweiligen Prozess. Schreib dazu, wer den Wert freigegeben hat und warum. So vermeidest du spätere Diskussionen à la „Das hatte doch jemand anders gemeint“.
Ein sinnvoller Bezugspunkt ist auch die technische Umgebung. Wenn ein Standort oder eine Plattform eine Rolle spielt, sollte die Wiederanlaufplanung dazu passen. Wer zusätzliche Orientierung braucht, kann die Standortfrage mit dem Server-Standort-Tool sauberer einordnen, weil Standort, Datenschutz und Wiederanlauf in der Praxis oft zusammenhängen.
Kurz gesagt, RTO und RPO sind keine Zahlen für die Schublade. Sie steuern, welche Systeme du zuerst behandelst, wie oft du sicherst und wie aggressiv du testen musst. Ohne diese Definitionen bleibt jeder DR-Plan weich und damit im Ernstfall unbrauchbar.
Backup Strategien und kreative Assets sichern
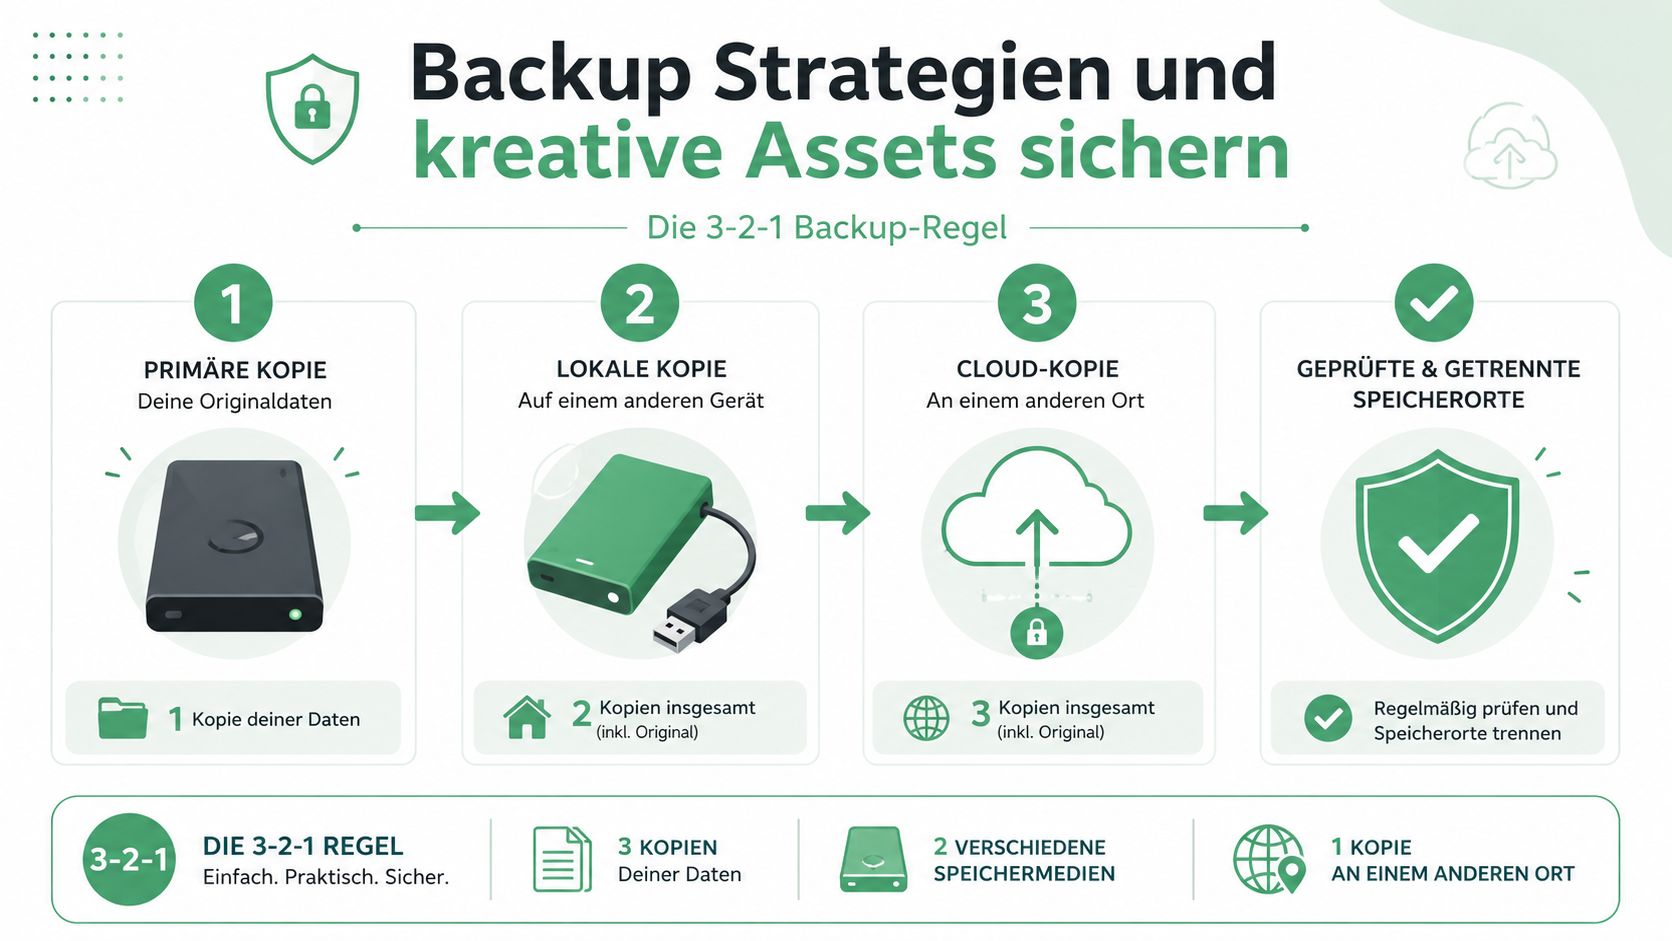
Bei kreativen Assets geht es nie nur um „die Datei ist gesichert“. Du brauchst Versionen, saubere Ordnerlogik, getrennte Speicherorte und einen Plan für den Fall, dass der Zugriff auf ein ganzes Systemsegment weg ist. Genau hier hilft die 3-2-1-Regel, weil sie eine einfache, harte Basis liefert.
Die Regel verlangt drei Datenkopien auf zwei unterschiedlichen Medien, mit einer Kopie an einem externen Standort, und sie empfiehlt, Backup-Frequenzen an der Änderungsrate der Daten auszurichten (phoenixNAP zur 3-2-1-Regel). Für Kreativteams ist das nicht nur ein IT-Motto, sondern eine Produktionsfrage, weil Design-Dateien, Videos und Fotos häufig in kurzer Folge geändert werden und einzelne Zwischenstände später wertvoll sein können.
So sieht ein belastbarer Workflow aus
Die beste Praxis ist eine Kombination aus lokalem Speicher, Cloud und externem Ort. Ein NAS kann für schnelle Wiederherstellung im Alltag gut sein, Cloud-Speicher hält Teams flexibel, und eine externe Kopie schützt vor lokalen Ausfällen. Wichtig ist nicht das einzelne Produkt, sondern die Trennung der Ausfallrisiken.
Für Assets mit vielen Iterationen solltest du außerdem mit klaren Namensregeln arbeiten. FinaI, final2, wirklich_final und ähnliche Dateinamen sind im Ernstfall Gift, weil niemand weiss, welche Version freigegeben war. Ein sauberes digitales Asset-Management hilft dir, Versionen und Freigaben überhaupt erst sinnvoll zu strukturieren, deshalb ist der Blick auf Digital Asset Management mehr als nur Komfort.
"Praktischer Fehler: Viele Teams sichern Dateien, aber nicht die Ordnung, in der sie später wiedergefunden werden.
Was du für kreative Inhalte konkret sichern solltest
- Arbeitsdateien: PSD, AI, AE, Projektdateien, Schnitte und Rohmaterial.
- Freigabedokumente: Kommentare, Änderungslisten, Freigaben, Abnahmen.
- Exportstände: Master-Dateien, Web-Versionen, Social-Media-Exporte, Untertitel.
- Kontextdaten: Metadaten, Ordnerstruktur, Benennung, Referenzen.
Gerade bei Videos und Design-Assets lohnt es sich, Sicherungen nach dem Änderungsrhythmus zu staffeln. Häufig genutzte Projekte brauchen engere Sicherungsintervalle als archivierte Kampagnen. Der Punkt ist nicht, alles permanent in Echtzeit zu spiegeln, sondern die Sicherung so zu planen, dass du im Ernstfall den letzten brauchbaren Stand zurückholen kannst.
Was in der Praxis oft schiefgeht
Die meisten Probleme entstehen nicht durch fehlende Backups, sondern durch ungetestete Backups. Ein Team glaubt, abgesichert zu sein, bis beim Restore auffällt, dass die Datei korrupt ist, der Pfad fehlt oder die letzte Freigabe nur lokal auf einem Laptop lag. Genau deshalb sollte jeder Sicherungsplan einen Testlauf haben, bevor die Krise real wird.
Wenn du nur einen Teil der Kreativkette sichern willst, sichere zuerst die Elemente, die nicht rekonstruierbar sind. Das sind meist Kommentarbelege, freigegebene Versionen und eindeutige Endstände. Damit schützt du nicht nur Daten, sondern die gesamte Produktionslogik.
Kommunikations und Verantwortungsplan umsetzen
Im Notfall scheitern Teams selten an Technik allein, sondern an Unklarheit. Wer darf den Wiederanlauf auslösen, wer informiert Kund:innen, und wer entscheidet bei widersprüchlichen Rückmeldungen? Ein sauberer Kommunikations- und Verantwortungsplan nimmt genau diese Reibung aus dem System.
Die EDA weist darauf hin, dass Standard-Ratgeber oft schlecht abdecken, wie externe Personen ohne Systemzugang eingebunden werden und wie Zuständigkeiten revisionssicher dokumentiert werden sollten (EDA zu equitable recovery). Für Kreativteams ist das ein echter Blindspot, weil Reviews oft mit Kund:innen, Freelancer:innen oder Dienstleistern laufen, die im Krisenfall nicht einfach ins interne System springen können.
Eine einfache RACI-Logik für den Ernstfall
| Aufgabe | R | A | C | I |
|---|---|---|---|---|
| Ausfall feststellen | IT-Admin | Projektleitung | Agenturleitung | Externe Reviewer |
| Wiederanlauf freigeben | IT-Admin | Agenturleitung | Projektleitung | Kundenseite |
| Review-Links aktualisieren | Projektleitung | IT-Admin | Externe Reviewer | Agenturleitung |
| Kommunikationsstatus senden | Projektleitung | Agenturleitung | IT-Admin | Alle Beteiligten |
RACI funktioniert nur, wenn die Rollen im Notfall wirklich gelebt werden. R ist die ausführende Rolle, A trägt die Entscheidung, C wird konsultiert, I wird informiert. Der Fehler in vielen Teams ist nicht das Modell, sondern dass die A-Rolle nie eindeutig festgelegt wird.
So bindest du externe Reviewer sauber ein
Externe Personen brauchen im Notfall oft keinen Systemzugang, sondern einen kontrollierten Linkzugang. Das schützt Prozesse vor unnötigen Hürden und hält Feedbackströme am Leben, auch wenn interne Systeme gerade eingeschränkt sind. Wer Dateien dafür effizient weitergeben muss, sollte den internen Prozess zu File Transfer Management zumindest sauber mitdenken, weil der Übergang zwischen Sicherung, Freigabe und Versand sonst schnell bricht.
"Ohne klare Eskalation wird aus einem technischen Problem sofort ein Abstimmungsproblem.
Halte fest, wie die Kommunikation läuft, wenn E-Mail, Chat oder Projekttool ausfallen. Nutze dafür einfache, redundante Kanäle und dokumentiere, wer was wann freigibt. Die eigentliche Qualität eines Kommunikationsplans zeigt sich nicht im Normalbetrieb, sondern dann, wenn mehrere Beteiligte gleichzeitig unsicher sind und trotzdem jemand handeln muss.
Testen pflegen und Auditen deines DR Plans
Ein Disaster Recovery Plan ist nur dann etwas wert, wenn du ihn regelmässig gegen die Praxis hältst. IBM empfiehlt, den Plan fortlaufend zu testen, Mitarbeitende zu schulen und ihn auf Basis von Testergebnissen sowie neu erkannten Risiken zu aktualisieren (IBM Cloud zu Planning for DR). Genau das wird im Alltag oft liegen gelassen, weil der Plan im Normalbetrieb unsichtbar bleibt und erst im Ernstfall seine Schwächen zeigt.
Bei Kreativteams sehe ich denselben Fehler immer wieder: Dateien liegen zwar irgendwo im Backup, aber Freigaben, Review-Kommentare und Zugänge externer Reviewer hängen an einzelnen Personen oder an Tools, die im Krisenfall nicht sauber zusammenlaufen. Dann bringt dir das beste Restore wenig, wenn die letzte Designfreigabe fehlt oder ein Kunde seine Korrekturen nicht mehr einreichen kann.
Drei Testarten, die du wirklich brauchst
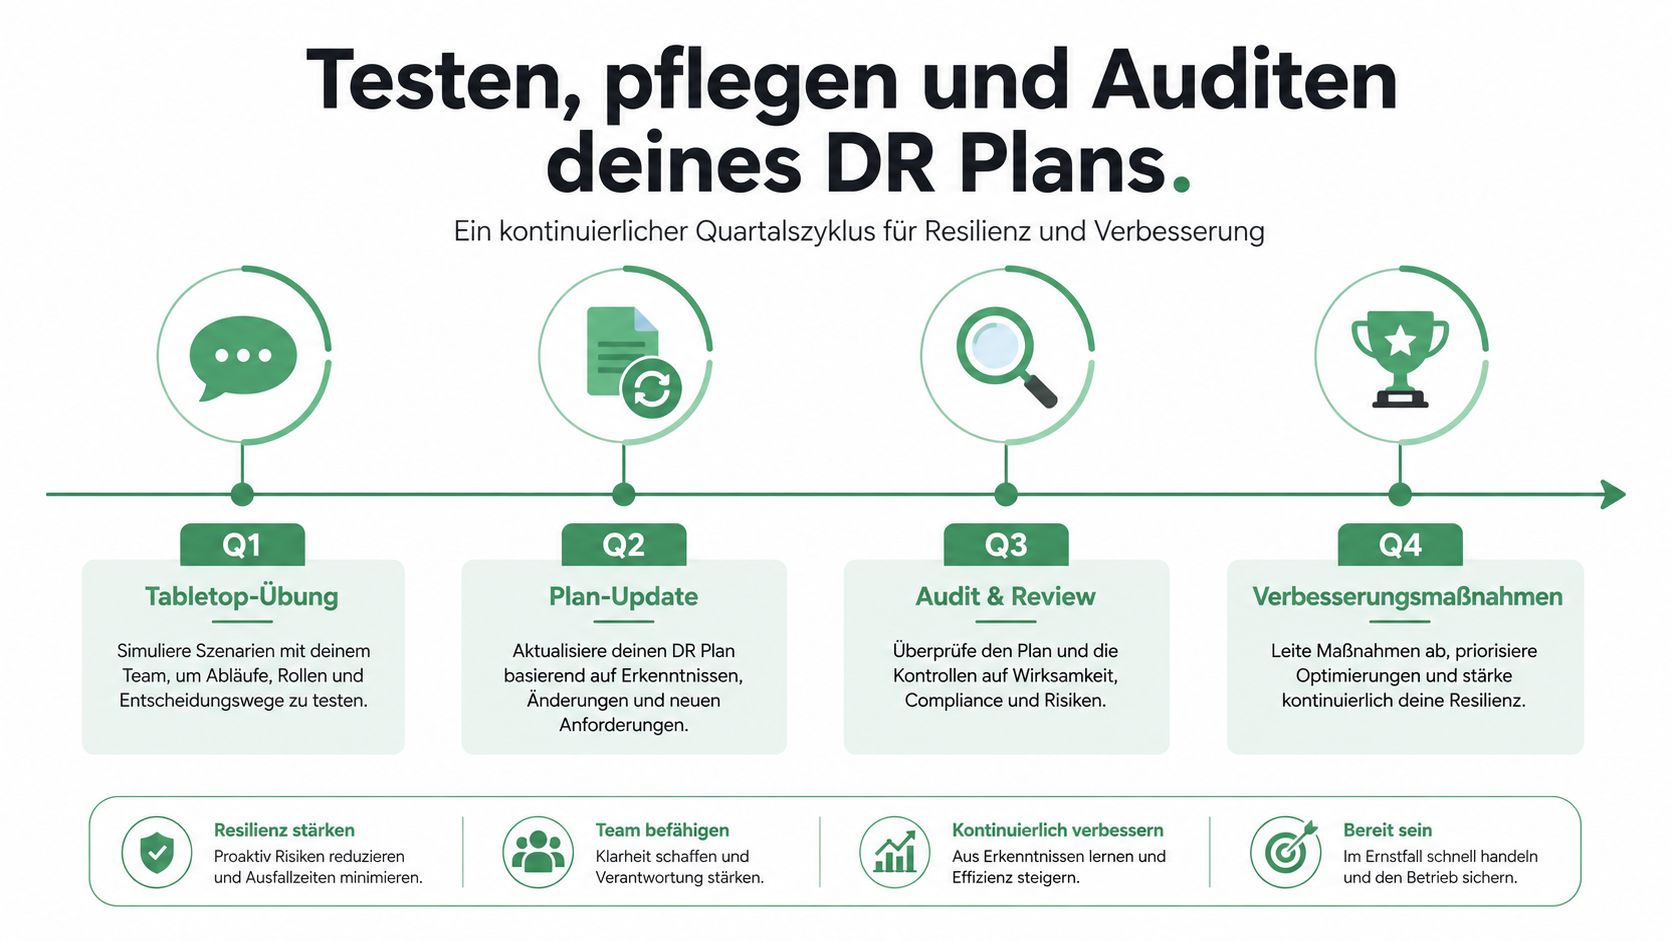
Die Reihenfolge ist klar und praxistauglich. Tabletop-Übungen prüfen, ob Rollen, Entscheidungen und Kommunikation funktionieren, ohne Systeme anzufassen. Teil-Failover-Tests validieren einzelne kritische Komponenten. Vollsimulationen zeigen dir, ob das Gesamtbild trägt, wenn mehrere Abhängigkeiten gleichzeitig ausfallen.
Atlassian beschreibt diese Prüfungen als sinnvolle Grundlage für Disaster Recovery, und die Taktung mit vierteljährlichen Tabletop-Übungen, halbjährlichen Teil-Failover-Tests und jährlichen Vollsimulationen gibt dir dafür eine brauchbare Orientierung. Wichtiger als der Test selbst ist das Protokoll danach. Was hat funktioniert, wo war jemand nicht erreichbar, und welche Schritte haben länger gedauert als erwartet?
Wann du den Plan sofort aktualisieren solltest
Nicht jede Änderung wartet auf den nächsten Planzyklus. Ein Update ist fällig nach grösseren Software-Änderungen, neuen Zugriffsmodellen, Personalwechseln oder neuen Dienstleistern. Gerade bei Kreativprozessen verändert sich der Alltag oft schneller als die Dokumentation, vor allem wenn Review-Workflows, Freigaben und externe Beteiligte mitlaufen.
Ein praktischer Wartungsrhythmus hält den Plan brauchbar:
- Nach jedem relevanten Systemwechsel: Zugriffe, Abhängigkeiten und Wiederanlaufreihenfolge prüfen.
- Nach Rollenwechseln: Kontaktliste, Freigabeketten und Eskalation nachziehen.
- Nach jedem Test: Lücken dokumentieren und direkt in die nächste Version einarbeiten.
- Vor wichtigen Projektphasen: Kritische Assets, Review-Schleifen und Freigaben neu bewerten.
Für frühe Teams und schnell wachsende Agenturen lohnt sich auch ein Blick auf den regulatory guide for startups, weil Compliance und Notfallfähigkeit sich oft überschneiden. Ein sauberer DR-Prozess macht Audits leichter, aber nur, wenn Protokolle, Verantwortlichkeiten und Rückverfolgbarkeit nicht erst im Nachhinein zusammengesucht werden.
"Wichtig: Testen ist keine Zusatzaufgabe. Es ist der Moment, in dem dein Plan belastbar wird oder sich als Papierkonstruktion entlarvt.
Wenn du einen Test sauber aufsetzt, lernst du fast immer mehr über deine Organisation als aus jedem Workshop. Manche Schwächen liegen in der Technik, viele aber in Freigaben, Zuständigkeiten und der Frage, wer im Ernstfall wirklich erreichbar ist. Genau deshalb gehört Pflege genauso fest in den Plan wie Backup und Restore.
Vorlagen Checklisten und bewährte Prozesse
Am Ende brauchst du keine Theorie mehr, sondern Arbeitsmaterial. Ein brauchbares Paket besteht aus einer Risikoanalyse-Vorlage, einer BIA-Matrix, einer RACI-Tabelle, einer Backup-Checkliste für kreative Assets und einem Testprotokoll für Wiederanläufe. Diese Dokumente funktionieren am besten zusammen, weil sie dieselben Fragen aus unterschiedlichen Blickwinkeln abdecken.
Was in dein Download-Paket gehört
- Risikoanalyse-Vorlage: Für Assets, Bedrohungen, Schwachstellen und Prioritäten.
- BIA-Matrix: Für kritische Prozesse, Ausfallfolgen und Priorisierung.
- RACI-Tabelle: Für Entscheidungen, Eskalation und Kommunikation.
- Backup-Checkliste: Für Dateien, Ordner, Medien und externe Kopien.
- Testprotokoll: Für Datum, Szenario, Abweichungen und Massnahmen.
Der grösste Fehler ist, Vorlagen getrennt zu behandeln. Wenn jede Datei in einem anderen Ordner oder Tool steckt, hast du im Notfall wieder denselben Wildwuchs wie vorher. Besser ist ein zentraler Arbeitsraum, in dem Kommentare, Versionen und Freigaben direkt am Asset hängen, statt über E-Mail-Ketten verteilt zu sein.
Ein sauberer Prozess spart dir doppelte Arbeit
Ein guter Prozess beginnt mit dem Asset selbst, nicht mit dem Dokument. Wenn ein Video, ein Layout oder eine Fotoauswahl aktualisiert wird, sollten zugehörige Freigaben, Kommentare und Prüfstände mitziehen. So bleibt nachvollziehbar, welche Version tatsächlich freigegeben wurde und wer noch etwas offen hatte.
Für deine interne Struktur hilft ein simples Prinzip. Erst die kritischen Assets identifizieren, dann die Wiederanlaufreihenfolge festlegen, dann die Kommunikationswege absichern, und erst danach die Tools wählen. Wer zu früh auf Software springt, baut oft nur Digitalisierung auf Unsicherheit.
Ein belastbarer Abschluss für deinen eigenen DR-Ordner ist deshalb kein langes Konzept, sondern ein Set klarer Arbeitsdokumente. Wenn du Risiko, BIA, RTO, RPO, Backup, Rollen und Tests an einer Stelle führst, wird aus Notfallplanung echte Betriebsfähigkeit.
Wenn du deinen DR-Prozess endlich so aufsetzen willst, dass Kreativ-Assets, Freigaben und externe Reviewer nicht an Excel-Listen und E-Mail-Pingpong scheitern, schau dir draftgo an. Dort bündelst du Kommentare, Versionen und Freigaben direkt am Asset, genau dort, wo sie im Ernstfall gebraucht werden. Das macht deinen Wiederanlauf nicht nur schneller, sondern auch sauber nachvollziehbar.
Geschrieben von
Emilia
Content Producer
Bereit, Ihre Freigabeprozesse zu optimieren?
Starten Sie noch heute mit draftgo und erleben Sie, wie einfach professionelle Zusammenarbeit sein kann.